Contexto y objetivo
Un análisis exploratorio sobre información de empleados de una empresa ficticia. El objetivo es describir la distribución del personal por región, departamento, estatus, género, modalidad laboral y educación, utilizando tablas y gráficos en Python.
Preparación y alcance de los datos
El notebook carga dataset_RRHH.xlsx con pd.read_excel desde Google Colab y examina su contenido con head() e info(). El archivo fuente no está incluido en el repositorio revisado.
Los análisis utilizan groupby, size, value_counts, sort_values y reset_index para contar y organizar empleados. No se documenta un proceso específico de imputación, eliminación de duplicados o limpieza de categorías.
Preguntas y análisis exploratorio
- ¿Cómo se distribuyen los empleados entre regiones y departamentos?
- ¿Qué proporción corresponde a personal activo e inactivo?
- ¿Cómo varía la modalidad laboral según departamento y educación?
- ¿Qué combinaciones de región y departamento concentran más personas?
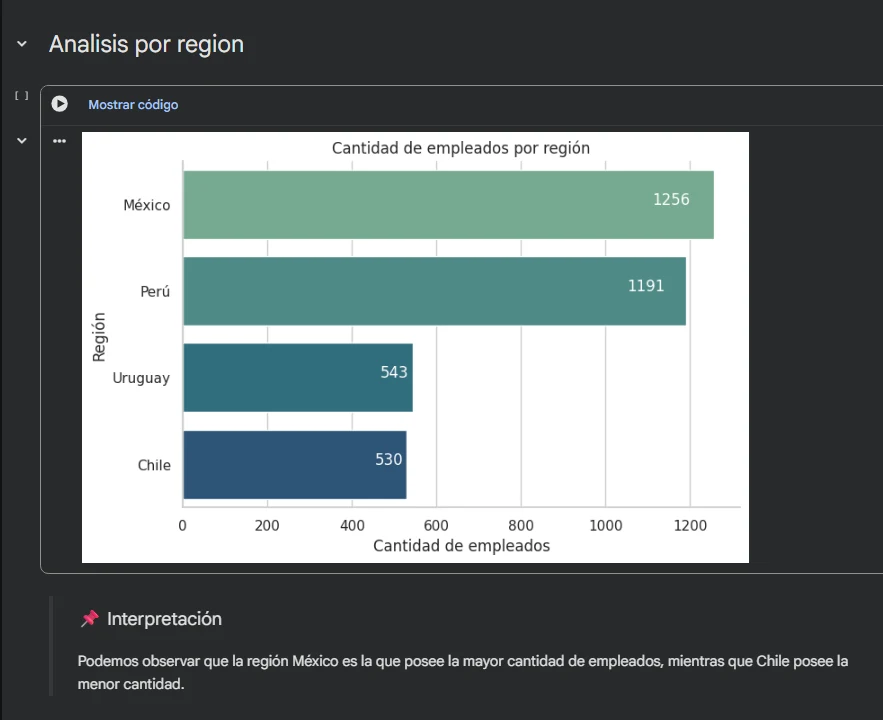
Se utilizan gráficos de barras, barras agrupadas y gráficos de anillo con Matplotlib y Seaborn. Las visualizaciones incluyen etiquetas de cantidades para facilitar su lectura.
empleados_region = (
    data.groupby('Región')
        .size()
        .sort_values(ascending=False)
)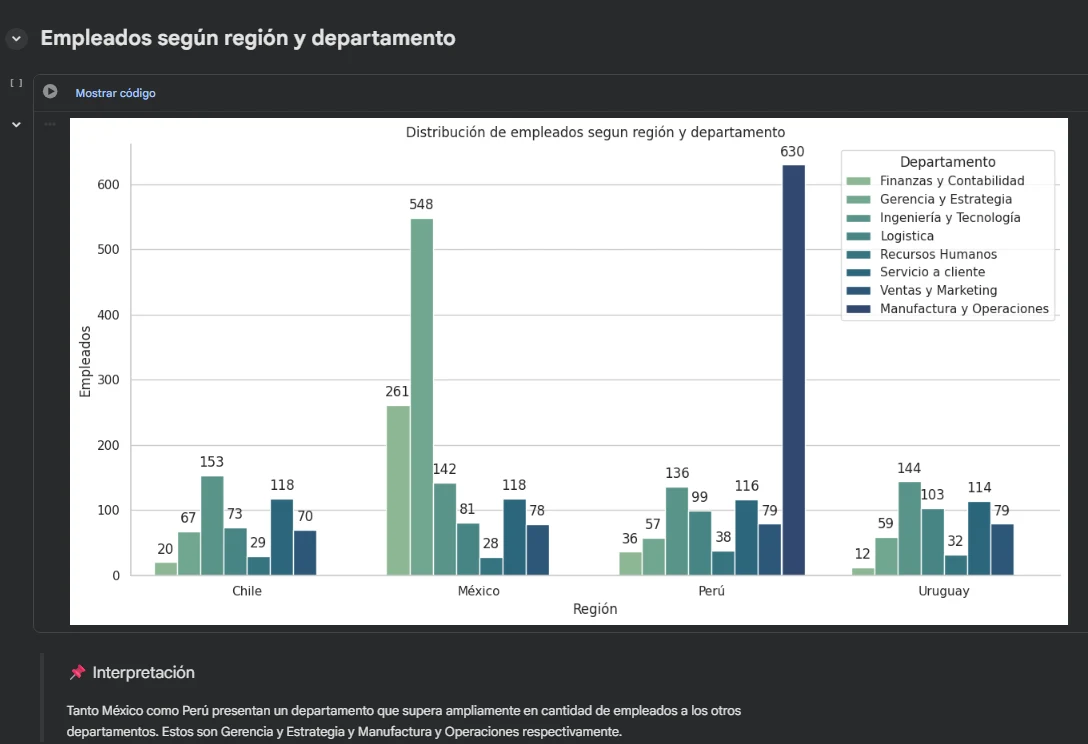
Visualización publicada · images/department & region_analysis.png
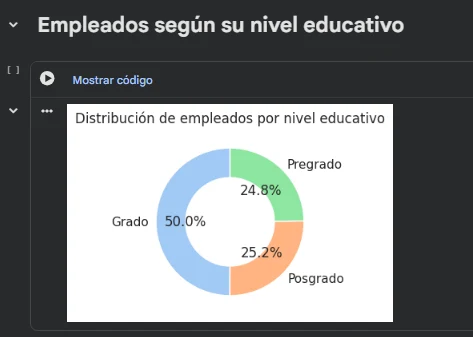
Visualización publicada · images/education_analysis.png
Resultados documentados
El README y las interpretaciones del notebook señalan que México concentra más empleados, Gerencia y Estrategia es el departamento con mayor presencia, el trabajo presencial predomina ligeramente y el estatus activo/inactivo tiene una distribución relativamente equilibrada.
Son observaciones sobre un dataset ficticio; no constituyen hallazgos sobre una empresa real ni recomendaciones causales.
Hay una inconsistencia interna entre la interpretación y la conclusión final del notebook sobre educación y modalidad laboral. Esa afirmación se omite en este caso. Al faltar el Excel fuente, los resultados se presentan como documentados, sin afirmar una validación independiente del cálculo.
Herramientas y aprendizajes
Python, Pandas, NumPy, Matplotlib, Seaborn y Google Colab. El trabajo permite practicar agrupaciones, frecuencias, comparaciones entre categorías y comunicación visual de patrones.
No hay consultas SQL ni un dashboard de Power BI en los archivos revisados. El README plantea un dashboard en Streamlit o Power BI como mejora futura.